几分钟生成字幕
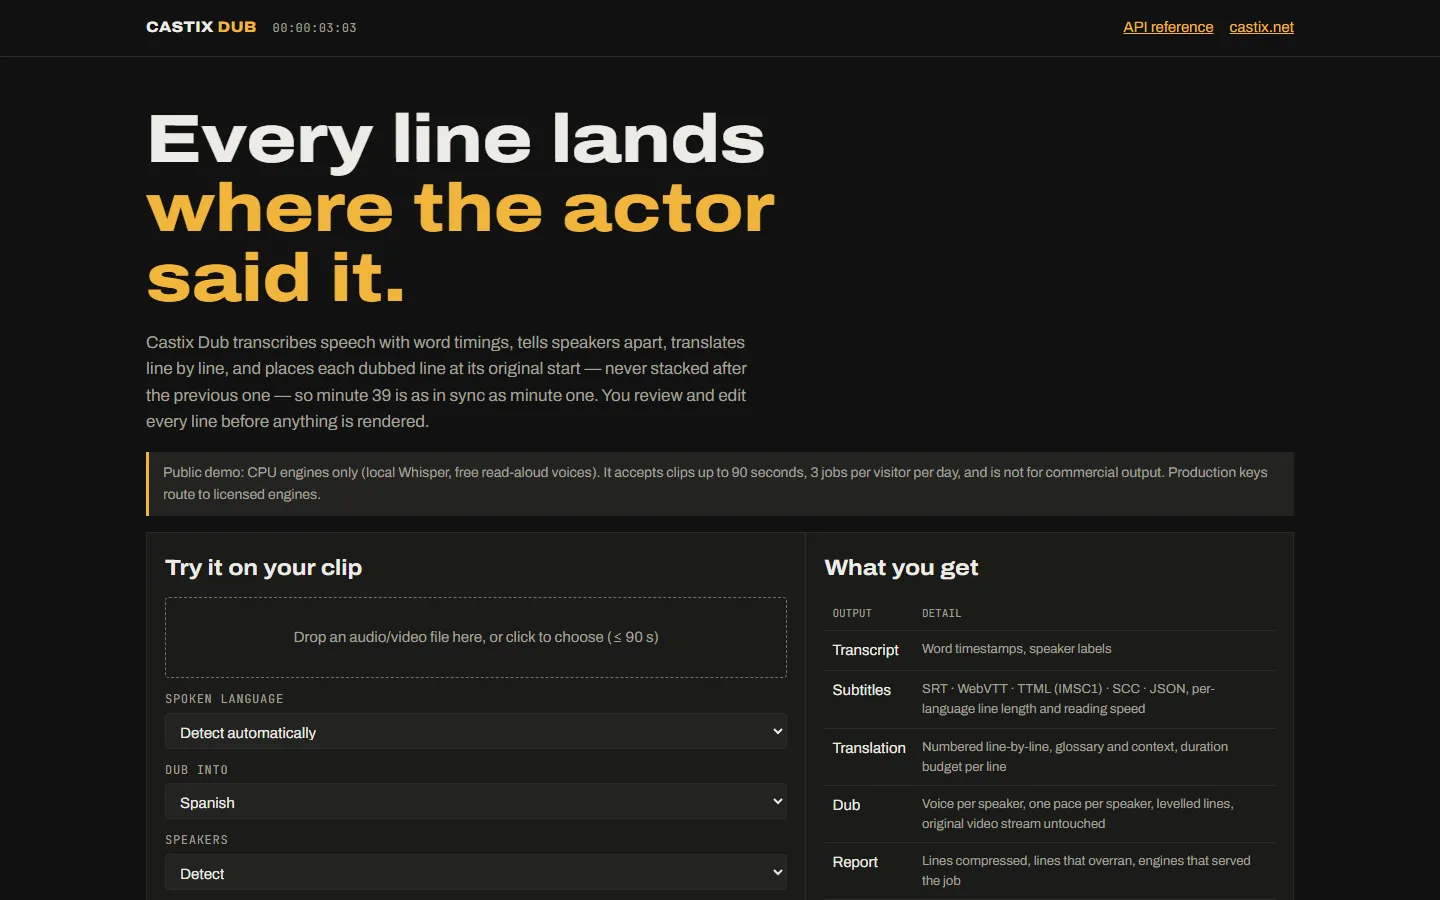
准确的字幕,长度和阅读速度都符合每种语言的规范。
一人一个声音
Dub 能听出谁在说话,并为每个人匹配合适的声音。
每一句都准时
每句台词都在原句开始时开始,第四十分钟和第一分钟一样同步。
保留本人声音,前提是同意
可选择保留说话人本人的声音,但必须有其录音授权。
适合谁: 广播电视机构、流媒体服务、课程制作者,以及需要面向多个国家发布视频的企业。
用您的语言听一听
一段原版片段,以及配成本页语言的版本。输出未经任何编辑。
演示配音使用免费的 Microsoft Edge 朗读语音(未获转售授权);正式产品使用已授权的语音。译文由人工在审校环节撰写。音乐为本演示专门生成。
三种购买方式
租用
由我们在您选定的区域为您运行。按月付费,含技术支持。
部署在您的服务器上
按年授权,安装在您自己的机房或云上。您的视频始终不离开您的网络。
买下源代码
购买完整源代码和文档,并由编写代码的工程师与您完成交接。
技术细节
写给您的工程师:它具体做什么、如何构建、我们实测的数据,以及与同类产品的对比。
功能
转写、字幕、翻译和配音,为每位说话人分配一个声音,并放置在原始时间点。仅在有录音同意的情况下进行声音克隆。
转写
语音转文字,附带逐词时间,可直接用于字幕、搜索和合规。
字幕
SRT、WebVTT 和 ASS,或直接压制进画面,遵循每行 42 个字符、最多两行、每秒 17 个字符的规则。
翻译
在配音前翻译字幕和脚本,包括阿拉伯语等从右到左书写的语言。
说话人识别
识别有几个人在说话、谁说了什么,再按性别和音高为每个人选择声音。
时间锁定配音
每句台词都放在原片中的绝对时间点。语速最多加快到 1.35×,绝不放慢,放不下的部分会在报告中列出。
干净的成品
有人说话时自动压低原声,混音经过两遍响度标准化,视频流直接复制,不重新编码。
经同意的声音克隆
可选择在获得录音同意后克隆说话人本人的声音;任务完成后即删除克隆声音。
路线图:口型同步、术语表和更多配音声音。每完成一轮 Common Voice 测试,我们就会公布该语言的转写准确率。
工作原理
转写
语音变成带时间码的文本。
识别说话人
对声音进行聚类,为每位说话人分配配音声音。
翻译
翻译台词并对照时间进行检查。
配音
生成每句台词的语音并放在原始时间点。
成品
闪避压低、响度处理和封装;导出字幕。
数据及其测量方法
本网站的每个数字都来自可重复的测试。凡是目标值,都会明确标注。
方法Common Voice 17 测试集,50 段音频,CPU 基线模型。其他语言正在测量中。
方法12 个句子,合成语音往返测试。这是干净音频下的最佳情况,不代表嘈杂录音的表现。
方法对白下方有音乐的真实语音,经背景分离后测得。
方法两遍响度标准化,在输出端测量。
技术规格
| 语言 | 转写支持 38 种语言;配音声音支持英语、阿拉伯语、土耳其语、波斯语、德语、法语、西班牙语、俄语和中文 |
|---|---|
| 字幕格式 | SRT、WebVTT、TTML (IMSC1)、SCC、JSON、压制字幕 |
| 行规则 | 按语言设定,参照 Netflix Timed Text Style Guides(例如英语每行 42 个字符、每秒 20 个字符) |
| 时间 | 绝对定位;只压缩不拉伸,最多 1.35×;超出部分会报告 |
| 混音 | 台词间压低至 0.3,说话时压低至 0.05,150 ms 渐变;两遍响度标准化至 −16 LUFS |
| 任务上限 | 每个任务配音最长 20 分钟,转写最长 2 小时 |
| 声音克隆 | 需主动选择,录音同意,至少 10 s 说话人语音,用后删除 |
| 口型同步 | 路线图 |
授权与定价模式
价格取决于用量和部署方式。我们会在两个工作日内报价。
按分钟、按环节
转写 · 字幕 · 翻译 · 配音只为您需要的环节付费。
分钟套餐
按月适用于用量稳定的团队。
按节目套餐
剧集或电影播出交付一口价,含审核。
私有部署
按年,按 GPU 节点适用于不能将音频发送到公有云的广播电视机构和组织。
买家常见问题
转写准确率如何?
使用我们的 CPU 基线模型,在 50 段 Common Voice 英语音频上的词错误率为 12.9%;生产级引擎表现更好。每种语言测试完成后,我们会连同测试方法一并公布。
配音会不同步吗?
每句台词都放在原句的开始时间,绝不拉长。如果某句即使加速到 1.35× 也放不下,任务报告会列出这一句,方便剪辑师缩短。
能处理多少位说话人?
系统会识别说话人数量,并为每个人分配声音。在给定说话人数量的情况下,72 段真实录音的标注准确率为 91%。
能克隆我们主持人的声音吗?
必须有主持人的录音同意。克隆声音仅用于本次任务,之后即删除。
导出哪些字幕格式?
SRT、WebVTT、TTML、SCC 和 JSON,也可以把字幕压制进画面。
有口型同步吗?
还没有。它已列入路线图,在完成测量之前,我们不会宣称支持。
可以私有化运行吗?
可以,通过私有部署授权,运行在您自己的 GPU 服务器上。