Ihre Videos in anderen Sprachen. Jeder Sprecher behält seine eigene Stimme.
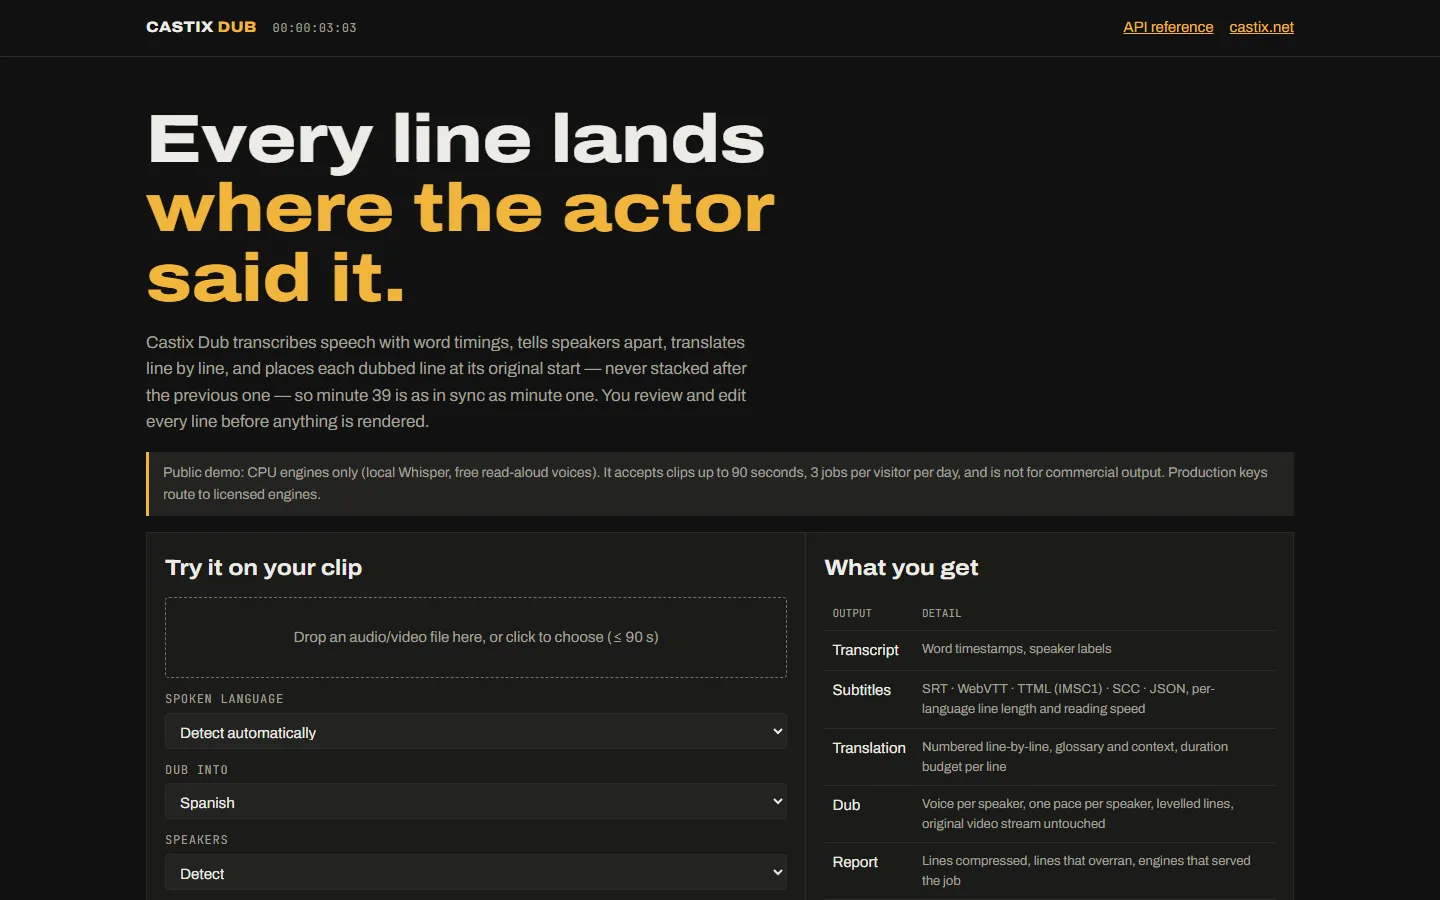
Laden Sie ein Video hoch. Dub erstellt die Untertitel, übersetzt sie und gibt jeder Person im Bild ihre eigene Stimme in der neuen Sprache, genau ab dem Moment, in dem sie zu sprechen beginnt.
Status: Die Engine läuft heute produktiv in einem Synchronisationsdienst für Endkunden. Castix Dub, die darauf aufbauende internationale API, ist in Entwicklung.
Untertitel in Minuten
Genaue Untertitel in der richtigen Länge und Lesegeschwindigkeit für jede Sprache.
Eine Stimme pro Sprecher
Dub erkennt, wer spricht, und gibt jeder Person eine passende Stimme.
Jede Zeile auf den Punkt
Jede Zeile beginnt dort, wo die Originalzeile begann. So ist Minute vierzig so synchron wie Minute eins.
Eigene Stimmen, mit Einwilligung
Auf Wunsch behalten die Sprecher ihre eigenen Stimmen, nur mit ihrer aufgezeichneten Zustimmung.
Für wen es gedacht ist: Sender, Streaming-Dienste, Anbieter von Online-Kursen und Unternehmen mit Videos für mehrere Länder.
Hören Sie es in Ihrer Sprache
Ein Originalclip und seine Synchronisation in die Sprache dieser Seite. Die Ergebnisse sind unbearbeitet.
Die Demo-Stimmen sind kostenlose Vorlesestimmen von Microsoft Edge (nicht für den Weiterverkauf lizenziert); im Betrieb kommen lizenzierte Stimmen zum Einsatz. Die Übersetzung haben Menschen im Prüfschritt geschrieben. Die Musik wurde für diese Demo erzeugt.
Drei Wege zum Kauf
Mieten
Wir betreiben es für Sie, in der Region Ihrer Wahl. Sie zahlen monatlich und erhalten Support.
Auf eigenen Servern
Eine Jahreslizenz für den Betrieb im eigenen Haus oder in Ihrer Cloud. Ihre Videos verlassen nie Ihr Netzwerk.
Den Code besitzen
Sie kaufen den vollständigen Quellcode mit Dokumentation und einer Übergabe durch die Entwickler, die ihn geschrieben haben.
Die technischen Details
Für Ihre Technik: was es genau tut, wie es gebaut ist, welche Werte wir gemessen haben und wie es im Vergleich abschneidet.
Was es kann
Transkribieren, untertiteln, übersetzen und synchronisieren, mit einer Stimme pro Sprecher, platziert am Originaltiming. Stimmklonen nur mit aufgezeichneter Einwilligung.
Transkription
Sprache zu Text mit Zeitstempeln pro Wort, bereit für Untertitel, Suche und Compliance.
Untertitel
SRT, WebVTT und ASS oder ins Bild eingebrannt, mit Zeilenregeln von 42 Zeichen, zwei Zeilen und 17 Zeichen pro Sekunde.
Übersetzung
Untertitel und Skripte vor der Vertonung übersetzen, auch in Rechts-nach-links-Sprachen wie Arabisch.
Sprechererkennung
Erkennt, wie viele Personen sprechen und wer was sagt, und wählt dann für jede eine Stimme nach Geschlecht und Tonhöhe.
Zeitgenaue Synchronisation
Jede Zeile wird an ihrem absoluten Originalzeitpunkt platziert. Die Sprache wird höchstens auf 1,35× beschleunigt, nie verlangsamt, und Überläufe werden gemeldet.
Sauberes Finishing
Der Originalton wird unter der Sprache abgesenkt, die Mischung in zwei Durchgängen lautheitsnormalisiert und der Videostream ohne Neucodierung übernommen.
Stimmklonen mit Einwilligung
Optional wird die eigene Stimme eines Sprechers geklont, mit aufgezeichneter Einwilligung. Der Klon wird nach dem Auftrag gelöscht.
Auf der Roadmap: Lippensynchronität, Glossare und weitere Synchronstimmen. Die Transkriptionsgenauigkeit veröffentlichen wir pro Sprache, sobald der jeweilige Common-Voice-Lauf abgeschlossen ist.
So funktioniert es
Transkribieren
Sprache wird zu getimtem Text.
Sprecher finden
Stimmen werden geclustert, und jeder Sprecher erhält eine Besetzungsstimme.
Übersetzen
Zeilen werden übersetzt und gegen das Timing geprüft.
Vertonen
Jede Zeile wird gesprochen und an ihrer Originalzeit platziert.
Finishing
Ducking, Lautheit und Muxing; Untertitel werden exportiert.
Zahlen mit Methode
Jede Zahl auf dieser Website stammt aus einem Lauf, den wir wiederholen können. Ist eine Zahl ein Ziel, steht das dabei.
MethodeCommon Voice 17 Testsatz, 50 Clips, CPU-Basismodell. Weitere Sprachen werden gerade gemessen.
Methode12 Sätze, Rundlauf mit synthetischer Sprache. Ein Bestwert für sauberen Ton, kein Versprechen für verrauschte Aufnahmen.
MethodeEchte Sprache mit Musik unter dem Dialog, nach Entfernen des Hintergrunds.
MethodeLautheitsnormalisierung in zwei Durchgängen, am Ergebnis gemessen.
Spezifikationen
| Sprachen | Transkription in 38 Sprachen; Synchronstimmen auf Englisch, Arabisch, Türkisch, Persisch, Deutsch, Französisch, Spanisch, Russisch und Chinesisch |
|---|---|
| Untertitelformate | SRT, WebVTT, TTML (IMSC1), SCC, JSON, eingebrannt |
| Zeilenregeln | Pro Sprache, nach den Netflix Timed Text Style Guides (z. B. 42 Zeichen und 20 pro Sekunde im Englischen) |
| Timing | Absolute Platzierung; nur Verdichtung, bis 1,35×; Überlauf wird gemeldet |
| Mischung | Absenkung 0,3 zwischen Zeilen, 0,05 unter Sprache, 150 ms Übergänge; Lautheit in zwei Durchgängen auf −16 LUFS |
| Auftragsgrenzen | Synchronisation bis 20 Minuten, Transkription bis 2 Stunden pro Auftrag |
| Stimmklonen | Nur auf Wunsch, aufgezeichnete Einwilligung, mindestens 10 s vom Sprecher, nach Gebrauch gelöscht |
| Lippensynchronität | Roadmap |
Im Vergleich
| Funktion | Castix Dub | ElevenLabs | Rask.ai | HeyGen | Deepdub | Dubverse | Speechify |
|---|---|---|---|---|---|---|---|
| Transkription | Ja | Ja | Ja | Ja | Ja | Ja | Nicht verifiziert |
| Veröffentlichte Fehlerrate pro Sprache | Ja | Nein | Nicht verifiziert | Nicht verifiziert | Teilweise | Nicht verifiziert | Nicht verifiziert |
| SRT, VTT, ASS und eingebrannt | Ja | Nicht verifiziert | Teilweise | Teilweise | Nicht verifiziert | Teilweise | Nicht verifiziert |
| Synchronisation mit mehreren Sprechern | Ja | Ja | Ja | Ja | Ja | Nicht verifiziert | Nicht verifiziert |
| Timing-genaue Platzierung | Ja | Teilweise | Nicht verifiziert | Nicht verifiziert | Teilweise | Nicht verifiziert | Nicht verifiziert |
| Stimmklonen nur mit Einwilligung | Ja | Teilweise | Teilweise | Teilweise | Teilweise | Teilweise | Teilweise |
| Lippensynchronität | Roadmap | Nicht verifiziert | Teilweise | Ja | Teilweise | Nicht verifiziert | Nicht verifiziert |
| On-Premises | Ja | Nein | Nein | Nein | Nicht verifiziert | Nein | Nein |
Angaben zu Wettbewerbern wurden am 6. November 2026 auf den Websites der Anbieter geprüft. Die Links stehen in unseren Recherchenotizen. „Nicht verifiziert“ bedeutet, dass wir die Angabe nicht bestätigen konnten.
Lizenz- und Preismodelle
Die Preise hängen von Volumen und Bereitstellung ab. Sie erhalten unser Angebot innerhalb von zwei Werktagen.
Pro Minute, pro Schritt
Transkription · Untertitel · Übersetzung · SynchronisationSie zahlen nur für die Schritte, die Sie brauchen.
Minutenpakete
MonatlichFür Teams mit gleichmäßigem Volumen.
Paket pro Titel
Episode oder SpielfilmFestpreis für Sendeauslieferungen, Prüfung inklusive.
Private Bereitstellung
Jährlich, pro GPU-KnotenFür Sender und Institutionen, die kein Audio in eine Public Cloud senden dürfen.
Was Käufer fragen
Wie genau ist die Transkription?
12,9 % Wortfehlerrate im Englischen auf 50 Common-Voice-Clips mit unserem CPU-Basismodell; produktive Engines schneiden besser ab. Wir veröffentlichen jede Sprache mit ihrem Test, sobald er abgeschlossen ist.
Läuft die Synchronisation asynchron?
Jede Zeile beginnt an ihrem ursprünglichen Startzeitpunkt und wird nie gedehnt. Passt eine Zeile selbst bei 1,35× nicht, nennt der Auftragsbericht sie, damit jemand im Schnitt sie kürzen kann.
Wie viele Sprecher kann es verarbeiten?
Es erkennt die Zahl der Sprecher und weist jedem eine Stimme zu. Bei vorgegebener Sprecherzahl war die Zuordnung auf 72 echten Aufnahmen zu 91 % korrekt.
Können Sie die Stimme unseres Moderators klonen?
Nur mit der aufgezeichneten Einwilligung des Moderators. Der Klon wird für den Auftrag genutzt und danach gelöscht.
Welche Untertitelformate exportieren Sie?
SRT, WebVTT, TTML, SCC und JSON oder ins Bild eingebrannte Untertitel.
Gibt es Lippensynchronität?
Noch nicht. Sie steht auf der Roadmap, und wir werben erst damit, wenn sie gemessen ist.
Können wir es privat betreiben?
Ja, mit einer Lizenz für den privaten Betrieb auf Ihren eigenen GPU-Servern.