ویدیوهای شما به زبانهای دیگر. هر گوینده صدای خودش را دارد.
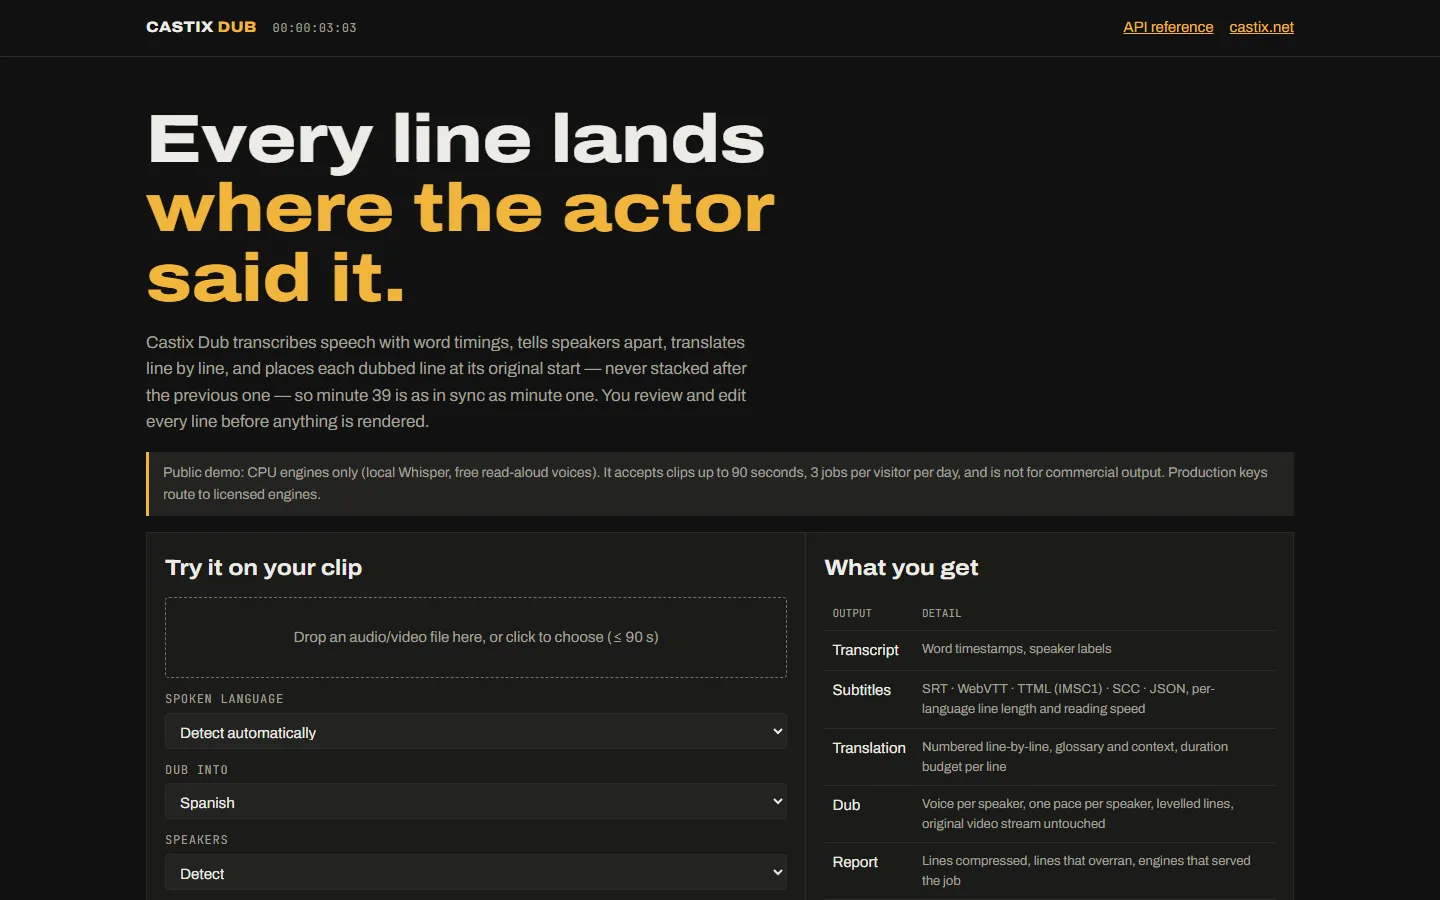
یک ویدیو آپلود کنید. Dub زیرنویس را مینویسد، ترجمهاش میکند و به هر کسی که روی صفحه است صدای خودش را به زبان تازه میدهد، درست از همان لحظهای که شروع به حرف زدن میکند.
وضعیت: این موتور امروز در یک سرویس دوبلهٔ عمومی در حال کار است. Castix Dub، یعنی API بینالمللی که روی آن ساخته میشود، در حال توسعه است.
زیرنویس در چند دقیقه
زیرنویس دقیق، با طول و سرعت خواندن مناسب هر زبان.
یک صدا برای هر گوینده
Dub میشنود چه کسی حرف میزند و به هر نفر صدایی متناسب میدهد.
سر وقت، جمله به جمله
هر جمله وقتی شروع میشود که جملهٔ اصلی شروع شده بود؛ دقیقهٔ چهلم هم مثل دقیقهٔ اول هماهنگ است.
صدای خود گویندهها، با رضایت
اگر بخواهید، صدای خود گویندهها را نگه دارید، فقط با اجازهٔ ضبطشدهٔ خودشان.
مناسب چه کسانی است: شبکههای پخش، سرویسهای استریم، سازندگان دورههای آموزشی و شرکتهایی که برای چند کشور ویدیو دارند.
به زبان خودتان گوش دهید
یک کلیپ اصلی و دوبلهٔ آن به زبان همین صفحه. خروجیها ویرایش نشدهاند.
صداهای این نمونه، صداهای رایگانِ بلندخوانیِ Microsoft Edge هستند (بدون مجوز فروش مجدد)؛ نسخهٔ واقعی از صداهای دارای مجوز استفاده میکند. ترجمه را انسان در مرحلهٔ بازبینی نوشته است. موسیقی برای همین نمونه ساخته شده است.
سه راه برای خرید
اجاره کنید
ما آن را برایتان در منطقهای که انتخاب میکنید اجرا میکنیم. ماهانه پرداخت میکنید و پشتیبانی میگیرید.
روی سرورهای خودتان
لایسنس سالانه برای نصب در ساختمان یا ابر خودتان. ویدیوهای شما هرگز از شبکهتان خارج نمیشوند.
مالک کد شوید
کد منبع کامل را همراه با مستندات میخرید و مهندسانی که آن را نوشتهاند تحویلش میدهند.
جزئیات فنی
برای مهندسان شما: دقیقاً چه میکند، چطور ساخته شده، چه اعدادی اندازه گرفتهایم و در مقایسه با بقیه کجا میایستد.
چه میکند
پیادهسازی متن، زیرنویس، ترجمه و دوبله با صدایی جدا برای هر گوینده، درست در زمانبندی اصلی. شبیهسازی صدا فقط با رضایت ضبطشده.
پیادهسازی متن
تبدیل گفتار به متن با زمان هر کلمه، آماده برای زیرنویس، جستوجو و انطباق.
زیرنویس
SRT، WebVTT و ASS، یا حکشده روی تصویر، با قاعدهٔ 42 نویسه در سطر، دو سطر و 17 نویسه در ثانیه.
ترجمه
ترجمهٔ زیرنویس و متن پیش از صداگذاری، از جمله زبانهای راستبهچپ مثل عربی.
تشخیص گوینده
میفهمد چند نفر حرف میزنند و چه کسی چه میگوید، بعد برای هر نفر بر اساس جنسیت و زیر و بمی صدا، صدایی انتخاب میکند.
دوبلهٔ قفلشده روی زمان
هر جمله در زمان مطلق اصلیاش قرار میگیرد. گفتار حداکثر تا 1.35× تند میشود، هرگز کند نمیشود و سرریزها گزارش میشوند.
پایانبندی تمیز
صدای اصلی زیر گفتار پایین میآید، بلندی میکس در دو مرحله نرمال میشود و ویدیو بدون رمزگذاری دوباره کپی میشود.
شبیهسازی صدا با رضایت
شبیهسازی اختیاری صدای خود گوینده با رضایت ضبطشده؛ صدای شبیهسازیشده بعد از کار حذف میشود.
در نقشهٔ راه: هماهنگی لب، واژهنامهها و صداهای دوبلهٔ بیشتر. دقت پیادهسازی متن برای هر زبان، با کامل شدن هر اجرای Common Voice منتشر میشود.
چطور کار میکند
پیادهسازی متن
گفتار به متن زماندار تبدیل میشود.
یافتن گویندهها
صداها خوشهبندی میشوند و هر گوینده یک صدای انتخابشده میگیرد.
ترجمه
جملهها ترجمه و با زمانبندی تطبیق داده میشوند.
صداگذاری
هر جمله گفته میشود و در زمان اصلیاش قرار میگیرد.
پایانکار
داکینگ، تنظیم بلندی صدا و مالتیپلکس؛ زیرنویسها صادر میشوند.
اعداد، همراه با روش اندازهگیری
هر عددی در این سایت از اجرایی میآید که میتوانیم تکرارش کنیم. اگر عددی هدف باشد، همین را صریح میگوید.
روشمجموعهٔ آزمون Common Voice 17، 50 کلیپ، مدل پایهٔ CPU. زبانهای دیگر در حال اندازهگیریاند.
روش12 جمله، رفتوبرگشت با گفتار مصنوعی. کف دقت برای صدای تمیز است، نه وعدهای برای ضبطهای پرنویز.
روشگفتار واقعی با موسیقی زیر دیالوگ، پس از جداسازی پسزمینه.
روشنرمالسازی دومرحلهای بلندی، اندازهگیریشده روی خروجی.
مشخصات فنی
| زبانها | پیادهسازی متن به 38 زبان؛ صداهای دوبله به انگلیسی، عربی، ترکی، فارسی، آلمانی، فرانسوی، اسپانیایی، روسی و چینی |
|---|---|
| فرمتهای زیرنویس | SRT، WebVTT، TTML (IMSC1)، SCC، JSON، حک روی تصویر |
| قواعد سطر | برای هر زبان، بر پایهٔ راهنمای سبک Timed Text از Netflix (مثلاً 42 نویسه و 20 نویسه در ثانیه برای انگلیسی) |
| زمانبندی | جایگذاری مطلق؛ فقط فشردهسازی، تا 1.35×؛ سرریز گزارش میشود |
| میکس | داکینگ 0.3 بین جملهها، 0.05 زیر گفتار، شیب 150 ms؛ نرمالسازی دومرحلهای بلندی تا −16 LUFS |
| محدودیت هر کار | دوبله تا 20 دقیقه، پیادهسازی متن تا 2 ساعت برای هر کار |
| شبیهسازی صدا | اختیاری، با رضایت ضبطشده، دستکم 10 s از صدای گوینده، حذف پس از استفاده |
| هماهنگی لب | در نقشهٔ راه |
مقایسه
| قابلیت | Castix Dub | ElevenLabs | Rask.ai | HeyGen | Deepdub | Dubverse | Speechify |
|---|---|---|---|---|---|---|---|
| پیادهسازی متن | بله | بله | بله | بله | بله | بله | تأییدنشده |
| نرخ خطای منتشرشده برای هر زبان | بله | خیر | تأییدنشده | تأییدنشده | جزئی | تأییدنشده | تأییدنشده |
| SRT، VTT، ASS و حک روی تصویر | بله | تأییدنشده | جزئی | جزئی | تأییدنشده | جزئی | تأییدنشده |
| دوبلهٔ چندگوینده | بله | بله | بله | بله | بله | تأییدنشده | تأییدنشده |
| جایگذاری قفلشده به زمان | بله | جزئی | تأییدنشده | تأییدنشده | جزئی | تأییدنشده | تأییدنشده |
| شبیهسازی صدا منوط به رضایت | بله | جزئی | جزئی | جزئی | جزئی | جزئی | جزئی |
| همگامسازی لب | نقشهٔ راه | تأییدنشده | جزئی | بله | جزئی | تأییدنشده | تأییدنشده |
| درونسازمانی | بله | خیر | خیر | خیر | تأییدنشده | خیر | خیر |
اطلاعات رقبا در ۶ نوامبر ۲۰۲۶ روی صفحههای خود فروشندگان بررسی شد. پیوندها در یادداشتهای پژوهشی ما آمده است. «تأییدنشده» یعنی نتوانستیم آن را تأیید کنیم.
مدلهای لایسنس و قیمتگذاری
قیمت به حجم و نوع استقرار بستگی دارد. ظرف دو روز کاری پیشفاکتور میدهیم.
بهازای هر دقیقه، هر لایه
پیادهسازی متن · زیرنویس · ترجمه · دوبلهفقط برای مراحلی که لازم دارید بپردازید.
بستهٔ دقیقه
ماهانهبرای تیمهایی با حجم کار ثابت.
بستهٔ هر عنوان
قسمت یا فیلم سینماییقیمت ثابت برای تحویلهای پخش، شامل بازبینی.
استقرار خصوصی
سالانه، بهازای هر نود GPUبرای سازمانهای پخش و نهادهایی که نمیتوانند صدا را به ابر عمومی بفرستند.
پرسشهای خریداران
پیادهسازی متن چقدر دقیق است؟
نرخ خطای کلمه 12.9% در انگلیسی، روی 50 کلیپ Common Voice با مدل پایهٔ CPU ما؛ موتورهای تولیدی بهتر عمل میکنند. هر زبان را همراه با آزمونش، با کامل شدنش منتشر میکنیم.
دوبله از هماهنگی خارج میشود؟
هر جمله در زمان شروع اصلیاش قرار میگیرد و هرگز کش نمیآید. اگر جملهای حتی با 1.35× جا نشود، گزارش کار نامش را میآورد تا تدوینگر کوتاهش کند.
با چند گوینده کنار میآید؟
تعداد گویندهها را تشخیص میدهد و به هر نفر صدایی اختصاص میدهد. وقتی تعداد گویندهها داده شد، برچسبگذاری روی 72 ضبط واقعی 91% دقیق بود.
میتوانید صدای مجری ما را شبیهسازی کنید؟
فقط با رضایت ضبطشدهٔ خود مجری. صدای شبیهسازیشده برای همان کار استفاده و بعد حذف میشود.
چه فرمتهای زیرنویسی خروجی میدهید؟
SRT، WebVTT، TTML، SCC و JSON، یا زیرنویس حکشده روی تصویر.
هماهنگی لب دارد؟
هنوز نه. در نقشهٔ راه است و تا اندازهاش نگیریم ادعایش نمیکنیم.
میتوانیم آن را خصوصی اجرا کنیم؟
بله، با لایسنس استقرار خصوصی روی سرورهای GPU خودتان.