فيديوهاتك بلغات أخرى، وكل متحدث يحتفظ بصوته.
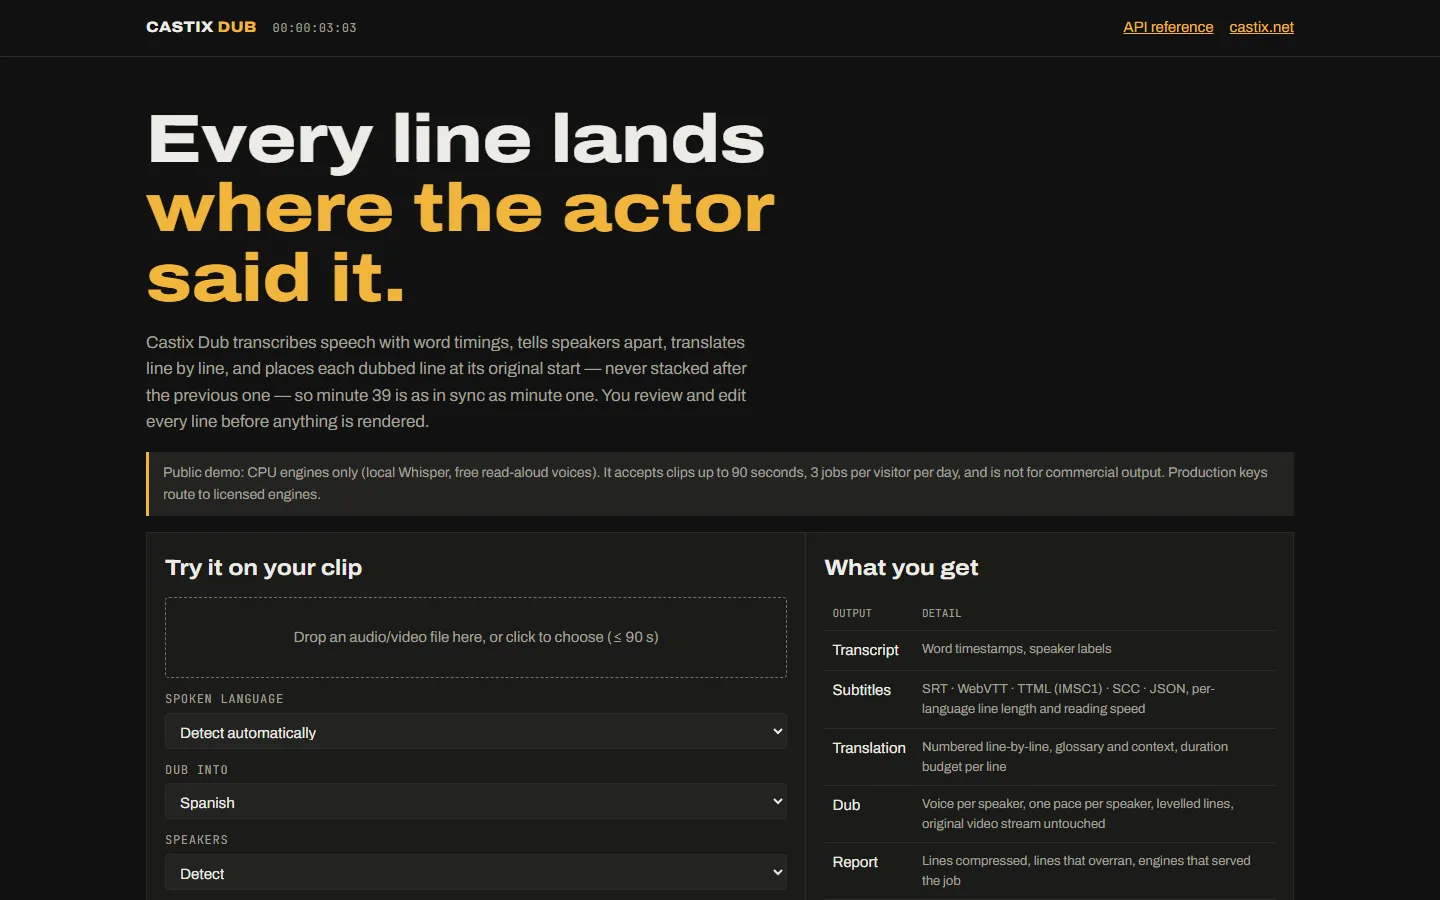
ارفع فيديو. يكتب Dub الترجمة النصية، ويترجمها، ويمنح كل شخص على الشاشة صوته الخاص باللغة الجديدة، ليبدأ الكلام في اللحظة نفسها التي بدأ فيها.
الحالة: يعمل المحرّك اليوم في بيئة الإنتاج ضمن خدمة دبلجة للمستهلكين. أما Castix Dub، واجهة API الدولية المبنية عليه، فقيد التطوير.
ترجمة نصية في دقائق
ترجمة نصية دقيقة بالطول وسرعة القراءة المناسبين لكل لغة.
صوت لكل متحدث
يميّز Dub من يتكلم ويمنح كل شخص صوتًا يناسبه.
في موعدها، جملة بجملة
تبدأ كل جملة حين بدأت الجملة الأصلية، فتبقى الدقيقة الأربعون متزامنة كالدقيقة الأولى.
أصواتكم الحقيقية، بموافقة
يمكنك الاحتفاظ بأصوات المتحدثين أنفسهم، فقط بإذن مسجّل منهم.
لمن هذا المنتج: هيئات البث، وخدمات البث التدفقي، وصانعو الدورات التعليمية، والشركات التي لديها فيديوهات لعدة بلدان.
استمع بلغتك
مقطع أصلي ودبلجته إلى لغة هذه الصفحة. المخرجات دون أي تعديل.
أصوات هذا العرض هي أصوات القراءة المجانية في Microsoft Edge (غير مرخّصة لإعادة البيع)، أما الإنتاج الفعلي فيستخدم أصواتًا مرخّصة. كتب الترجمةَ أشخاصٌ في مرحلة المراجعة. الموسيقى مولَّدة لهذا العرض.
ثلاث طرق للشراء
استأجره
نشغّله لك في المنطقة التي تختارها. تدفع شهريًا وتحصل على الدعم.
شغّله على خوادمك
ترخيص سنوي لتثبيته في مقرّك أو سحابتك الخاصة. فيديوهاتك لا تغادر شبكتك أبدًا.
امتلك الشيفرة
تشتري الشيفرة المصدرية كاملة مع التوثيق، ويسلّمك إياها المهندسون الذين كتبوها.
التفاصيل التقنية
لمهندسيك: ما الذي يفعله بالضبط، وكيف بُني، والأرقام التي قسناها، وكيف يُقارَن بغيره.
ما الذي يقدّمه
فرّغ الكلام نصيًا، وأضف الترجمة النصية، وترجم، ودبلج بصوت لكل متحدث يوضع في توقيته الأصلي. استنساخ الصوت فقط بموافقة مسجّلة.
التفريغ النصي
تحويل الكلام إلى نص مع توقيت كل كلمة، جاهز للترجمة النصية والبحث والامتثال.
الترجمة النصية
SRT وWebVTT وASS، أو مدمجة في الصورة، بقواعد سطر من 42 حرفًا وسطرين و17 حرفًا في الثانية.
الترجمة
ترجمة النصوص والسيناريوهات قبل التعليق الصوتي، بما فيها اللغات التي تُكتب من اليمين إلى اليسار مثل العربية.
تمييز المتحدثين
يعرف عدد المتحدثين ومن يقول ماذا، ثم يختار صوتًا لكل منهم بحسب الجنس وطبقة الصوت.
دبلجة متزامنة التوقيت
توضع كل جملة في توقيتها الأصلي المطلق. يمكن تسريع الكلام حتى 1.35× كحد أقصى، ولا يُبطَّأ أبدًا، ويُبلَّغ عن أي تجاوز.
إنهاء نظيف
يُخفَض الصوت الأصلي تحت الكلام، ويُضبط مستوى الجهارة في مرحلتين، ويُنسخ مسار الفيديو دون إعادة ترميز.
استنساخ الصوت بموافقة
استنساخ اختياري لصوت المتحدث نفسه بموافقة مسجّلة؛ ويُحذف الصوت المستنسخ بعد انتهاء المهمة.
على خارطة الطريق: مزامنة الشفاه، والمسارد، ومزيد من أصوات الدبلجة. ننشر دقة التفريغ النصي لكل لغة فور اكتمال كل اختبار على Common Voice.
آلية العمل
التفريغ
يتحول الكلام إلى نص موقّت.
تحديد المتحدثين
تُجمَّع الأصوات، ويحصل كل متحدث على صوت مختار له.
الترجمة
تُترجم السطور وتُراجع مقابل التوقيت.
التعليق الصوتي
يُنطق كل سطر ويوضع في توقيته الأصلي.
التشطيب
خفض الصوت، وضبط الشدة، والدمج؛ وتُصدَّر الترجمات النصية.
أرقام مع منهجيتها
كل رقم في هذا الموقع مصدره تجربة يمكننا تكرارها. وإذا كان الرقم مستهدفًا، نذكر ذلك صراحة.
المنهجيةمجموعة اختبار Common Voice 17، و50 مقطعًا، ونموذج أساسي على CPU. اللغات الأخرى قيد القياس.
المنهجية12 جملة، بدورة كاملة من كلام مُولَّد. هذا حد أدنى للصوت النظيف، لا وعد للتسجيلات المليئة بالضجيج.
المنهجيةكلام حقيقي مع موسيقى تحت الحوار، بعد فصل الخلفية.
المنهجيةضبط الجهارة في مرحلتين، مقيس على المخرجات.
المواصفات
| اللغات | التفريغ النصي بـ 38 لغة؛ أصوات الدبلجة بالإنجليزية والعربية والتركية والفارسية والألمانية والفرنسية والإسبانية والروسية والصينية |
|---|---|
| صيغ الترجمة النصية | SRT، WebVTT، TTML (IMSC1)، SCC، JSON، دمج في الصورة |
| قواعد السطر | لكل لغة، وفق أدلة Netflix لأسلوب النصوص المؤقتة (مثلًا 42 حرفًا و20 حرفًا في الثانية بالإنجليزية) |
| التوقيت | وضع مطلق؛ ضغط فقط، حتى 1.35×؛ ويُبلَّغ عن التجاوز |
| المزج | خفض 0.3 بين الجمل، و0.05 تحت الكلام، وتدرّج 150 ms؛ ضبط الجهارة في مرحلتين إلى −16 LUFS |
| حدود المهمة | الدبلجة حتى 20 دقيقة، والتفريغ النصي حتى ساعتين لكل مهمة |
| استنساخ الصوت | اختياري، بموافقة مسجّلة، ويحتاج 10 s على الأقل من صوت المتحدث، ويُحذف بعد الاستخدام |
| مزامنة الشفاه | على خارطة الطريق |
المقارنة
| القدرة | Castix Dub | ElevenLabs | Rask.ai | HeyGen | Deepdub | Dubverse | Speechify |
|---|---|---|---|---|---|---|---|
| التفريغ النصي | نعم | نعم | نعم | نعم | نعم | نعم | لم يُتحقَّق منه |
| معدل خطأ منشور لكل لغة | نعم | لا | لم يُتحقَّق منه | لم يُتحقَّق منه | جزئي | لم يُتحقَّق منه | لم يُتحقَّق منه |
| SRT وVTT وASS ودمج في الصورة | نعم | لم يُتحقَّق منه | جزئي | جزئي | لم يُتحقَّق منه | جزئي | لم يُتحقَّق منه |
| دبلجة متعددة المتحدثين | نعم | نعم | نعم | نعم | نعم | لم يُتحقَّق منه | لم يُتحقَّق منه |
| وضع مقيّد بالتوقيت | نعم | جزئي | لم يُتحقَّق منه | لم يُتحقَّق منه | جزئي | لم يُتحقَّق منه | لم يُتحقَّق منه |
| استنساخ صوت مشروط بالموافقة | نعم | جزئي | جزئي | جزئي | جزئي | جزئي | جزئي |
| مزامنة الشفاه | خارطة الطريق | لم يُتحقَّق منه | جزئي | نعم | جزئي | لم يُتحقَّق منه | لم يُتحقَّق منه |
| داخل المقر | نعم | لا | لا | لا | لم يُتحقَّق منه | لا | لا |
تحقّقنا من معلومات المنافسين على صفحات الموردين أنفسهم في 6 نوفمبر 2026. الروابط في ملاحظاتنا البحثية. وتعني «لم يُتحقَّق منه» أننا لم نتمكن من تأكيد المعلومة.
نماذج الترخيص والتسعير
تعتمد الأسعار على الحجم ونمط النشر. نرسل عرض السعر خلال يومَي عمل.
لكل دقيقة، لكل طبقة
تفريغ · ترجمة نصية · ترجمة · دبلجةادفع فقط مقابل الخطوات التي تحتاجها.
باقات دقائق
شهريةللفرق ذات الحجم الثابت.
باقة لكل عنوان
حلقة أو فيلم روائيسعر ثابت لتسليمات البث، يشمل المراجعة.
نشر خاص
سنوي، لكل عقدة GPUلهيئات البث والمؤسسات التي لا يمكنها إرسال الصوت إلى سحابة عامة.
أسئلة يطرحها المشترون
ما دقة التفريغ النصي؟
معدل خطأ الكلمات 12.9% بالإنجليزية على 50 مقطعًا من Common Voice بنموذجنا الأساسي على CPU؛ ومحركات الإنتاج أفضل من ذلك. ننشر كل لغة مع اختبارها فور اكتماله.
هل ستكون الدبلجة غير متزامنة؟
توضع كل جملة عند توقيت بدايتها الأصلي ولا تُمطّ أبدًا. وإذا لم تتسع جملة حتى بسرعة 1.35×، يذكرها تقرير المهمة ليختصرها المحرّر.
كم متحدثًا يستطيع التعامل معهم؟
يكتشف عدد المتحدثين ويخصص صوتًا لكل منهم. وعند تزويده بعدد المتحدثين، بلغت دقة التمييز 91% على 72 تسجيلًا حقيقيًا.
هل يمكنكم استنساخ صوت مقدّمنا؟
فقط بموافقة مسجّلة من المقدّم. يُستخدم الصوت المستنسخ للمهمة ثم يُحذف.
ما صيغ الترجمة النصية التي تصدّرونها؟
SRT وWebVTT وTTML وSCC وJSON، أو ترجمة مدمجة في الصورة.
هل تتوفر مزامنة الشفاه؟
ليس بعد. إنها على خارطة الطريق، ولن ندّعيها قبل أن نقيسها.
هل يمكن تشغيله بشكل خاص؟
نعم، بترخيص نشر خاص على خوادم GPU لديك.