आपके वीडियो दूसरी भाषाओं में। हर बोलने वाले की अपनी आवाज़ बनी रहती है।
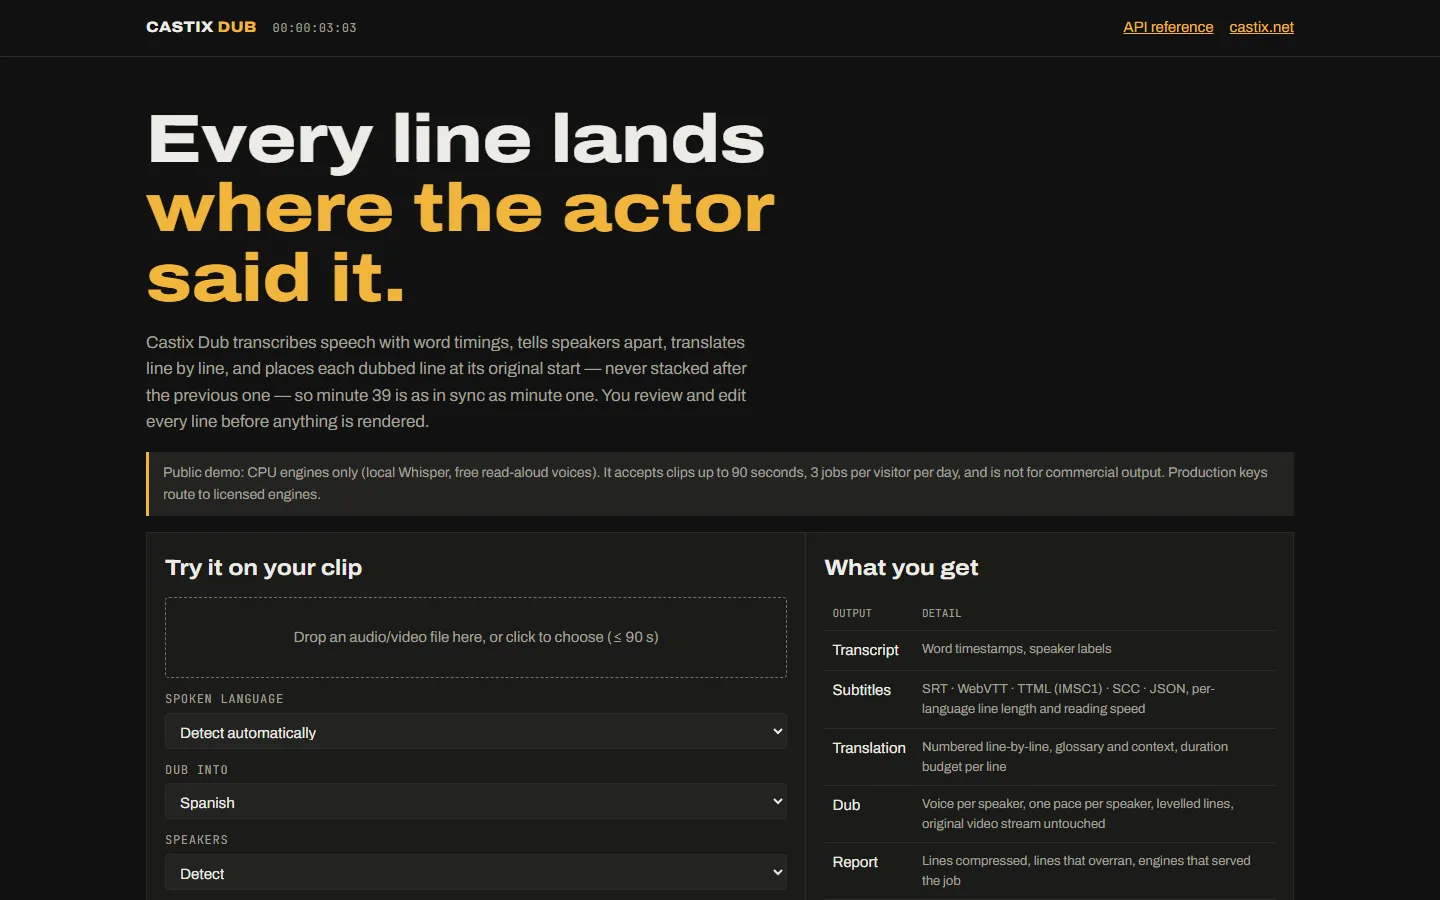
एक वीडियो अपलोड करें। Dub सबटाइटल लिखता है, उनका अनुवाद करता है, और स्क्रीन पर हर व्यक्ति को नई भाषा में उसकी अपनी आवाज़ देता है, ठीक उसी पल से जब वह बोलना शुरू करता है।
स्थिति: यह इंजन आज एक कंज़्यूमर डबिंग सर्विस में प्रोडक्शन में चल रहा है। इस पर बना इंटरनेशनल API, Castix Dub, डेवलपमेंट में है।
मिनटों में सबटाइटल
सटीक सबटाइटल, हर भाषा के लिए सही लंबाई और पढ़ने की सही रफ़्तार में।
हर स्पीकर की अपनी आवाज़
Dub सुनता है कि कौन बोल रहा है और हर व्यक्ति को मिलती-जुलती आवाज़ देता है।
हर लाइन समय पर
हर लाइन वहीं से शुरू होती है जहाँ मूल लाइन शुरू हुई थी, इसलिए चालीसवाँ मिनट भी पहले मिनट जितना ही सिंक में रहता है।
आपकी अपनी आवाज़ें, सहमति के साथ
चाहें तो स्पीकर्स की अपनी आवाज़ें रखें, सिर्फ़ उनकी रिकॉर्ड की गई अनुमति के साथ।
यह किसके लिए है: ब्रॉडकास्टर, स्ट्रीमिंग सर्विसेज़, कोर्स क्रिएटर और कई देशों के लिए वीडियो बनाने वाली कंपनियाँ।
अपनी भाषा में सुनें
एक मूल क्लिप और इस पेज की भाषा में उसका डब। आउटपुट बिना एडिट किए हैं।
डेमो की आवाज़ें Microsoft Edge की मुफ़्त पढ़कर सुनाने वाली आवाज़ें हैं (पुनर्विक्रय के लिए लाइसेंस नहीं); प्रोडक्शन में लाइसेंस वाली आवाज़ें इस्तेमाल होती हैं। अनुवाद समीक्षा चरण में लोगों ने लिखा है। संगीत इसी डेमो के लिए बनाया गया है।
खरीदने के तीन तरीके
किराए पर लें
हम इसे आपके लिए, आपके चुने हुए रीजन में चलाते हैं। आप हर महीने भुगतान करते हैं और आपको सपोर्ट मिलता है।
अपने सर्वर पर चलाएँ
सालाना लाइसेंस, ताकि आप इसे अपने ऑफ़िस या अपने क्लाउड में इंस्टॉल कर सकें। आपके वीडियो कभी आपके नेटवर्क से बाहर नहीं जाते।
कोड के मालिक बनें
आप पूरा सोर्स कोड खरीदते हैं, डॉक्यूमेंटेशन के साथ, और उसे लिखने वाले इंजीनियर्स खुद आपको हैंडओवर देते हैं।
तकनीकी जानकारी
आपके इंजीनियर्स के लिए: यह ठीक-ठीक क्या करता है, कैसे बना है, हमने कौन-से आँकड़े मापे और यह दूसरों से कैसे अलग है।
यह क्या करता है
ट्रांसक्राइब, सबटाइटल, अनुवाद और डब करें, हर स्पीकर के लिए एक आवाज़ के साथ, मूल टाइमिंग पर रखी हुई। वॉइस क्लोनिंग सिर्फ़ रिकॉर्ड की गई सहमति के साथ।
ट्रांसक्रिप्शन
शब्दों की टाइमिंग के साथ बोली से टेक्स्ट, सबटाइटल, सर्च और कंप्लायंस के लिए तैयार।
सबटाइटल
SRT, WebVTT और ASS, या तस्वीर में बर्न-इन, लाइन नियमों के साथ: 42 कैरेक्टर, दो लाइनें और 17 कैरेक्टर प्रति सेकंड।
अनुवाद
आवाज़ देने से पहले सबटाइटल और स्क्रिप्ट का अनुवाद, अरबी जैसी राइट-टू-लेफ़्ट भाषाओं समेत।
स्पीकर पहचान
पता लगाता है कि कितने लोग बोल रहे हैं और कौन क्या कहता है, फिर जेंडर और पिच के हिसाब से हर एक के लिए आवाज़ चुनता है।
टाइमिंग से बँधी डबिंग
हर लाइन अपने मूल समय पर ही रखी जाती है। बोली को ज़्यादा से ज़्यादा 1.35× तक तेज़ किया जा सकता है, कभी धीमा नहीं, और जो लाइन फ़िट न हो उसकी रिपोर्ट मिलती है।
साफ़ फ़िनिशिंग
बोली के नीचे मूल ऑडियो धीमा किया जाता है, मिक्स की लाउडनेस दो पास में नॉर्मलाइज़ होती है और वीडियो स्ट्रीम बिना री-एन्कोड किए कॉपी होती है।
सहमति के साथ वॉइस क्लोनिंग
रिकॉर्ड की गई सहमति के साथ, स्पीकर की अपनी आवाज़ की वैकल्पिक क्लोनिंग; काम पूरा होने के बाद क्लोन डिलीट कर दिया जाता है।
रोडमैप पर: लिप-सिंक, शब्दावली (glossaries) और ज़्यादा डबिंग आवाज़ें। ट्रांसक्रिप्शन एक्यूरेसी हर भाषा के लिए तब प्रकाशित होती है जब उसका Common Voice रन पूरा हो जाता है।
यह कैसे काम करता है
ट्रांसक्राइब
स्पीच टाइम किए गए टेक्स्ट में बदलती है।
स्पीकर पहचानें
आवाज़ों को क्लस्टर किया जाता है और हर स्पीकर को एक कास्ट वॉइस मिलती है।
अनुवाद
लाइनों का अनुवाद होता है और टाइमिंग के हिसाब से जाँच होती है।
वॉइस
हर लाइन बोली जाती है और उसके मूल समय पर रखी जाती है।
फ़िनिश
डकिंग, लाउडनेस और मक्सिंग; सबटाइटल एक्सपोर्ट होते हैं।
आँकड़े, उनकी पद्धति के साथ
इस साइट का हर आँकड़ा ऐसे रन से आता है जिसे हम दोहरा सकते हैं। जहाँ कोई संख्या लक्ष्य है, वहाँ यह साफ़ लिखा है।
पद्धतिCommon Voice 17 टेस्ट सेट, 50 क्लिप, CPU बेसलाइन मॉडल। बाकी भाषाएँ मापी जा रही हैं।
पद्धति12 वाक्य, सिंथेटिक स्पीच राउंड-ट्रिप। यह साफ़ ऑडियो के लिए न्यूनतम स्तर है, शोर वाली रिकॉर्डिंग के लिए वादा नहीं।
पद्धतिअसली बोली, डायलॉग के नीचे म्यूज़िक के साथ, बैकग्राउंड हटाने के बाद।
पद्धतिदो-पास लाउडनेस नॉर्मलाइज़ेशन, आउटपुट पर मापा गया।
स्पेसिफ़िकेशंस
| भाषाएँ | 38 भाषाओं में ट्रांसक्रिप्शन; अंग्रेज़ी, अरबी, तुर्की, फ़ारसी, जर्मन, फ़्रेंच, स्पैनिश, रूसी और चीनी में डबिंग आवाज़ें |
|---|---|
| सबटाइटल फ़ॉर्मैट | SRT, WebVTT, TTML (IMSC1), SCC, JSON, बर्न-इन |
| लाइन नियम | हर भाषा के अपने, Netflix Timed Text Style Guides के अनुसार (जैसे अंग्रेज़ी में 42 कैरेक्टर और 20 प्रति सेकंड) |
| टाइमिंग | मूल समय पर प्लेसमेंट; सिर्फ़ तेज़ करना, 1.35× तक; ओवरफ़्लो की रिपोर्ट |
| मिक्स | लाइनों के बीच डकिंग 0.3, बोली के नीचे 0.05, 150 ms रैंप; दो-पास लाउडनेस −16 LUFS तक |
| जॉब लिमिट | डबिंग 20 मिनट तक, ट्रांसक्रिप्शन 2 घंटे तक, प्रति जॉब |
| वॉइस क्लोनिंग | सिर्फ़ चुनने पर, रिकॉर्ड की गई सहमति, स्पीकर की कम से कम 10 s आवाज़, इस्तेमाल के बाद डिलीट |
| लिप-सिंक | रोडमैप पर |
तुलना
| क्षमता | Castix Dub | ElevenLabs | Rask.ai | HeyGen | Deepdub | Dubverse | Speechify |
|---|---|---|---|---|---|---|---|
| ट्रांसक्रिप्शन | हाँ | हाँ | हाँ | हाँ | हाँ | हाँ | सत्यापित नहीं |
| भाषा के अनुसार प्रकाशित एरर रेट | हाँ | नहीं | सत्यापित नहीं | सत्यापित नहीं | आंशिक | सत्यापित नहीं | सत्यापित नहीं |
| SRT, VTT, ASS और बर्न-इन | हाँ | सत्यापित नहीं | आंशिक | आंशिक | सत्यापित नहीं | आंशिक | सत्यापित नहीं |
| मल्टी-स्पीकर डबिंग | हाँ | हाँ | हाँ | हाँ | हाँ | सत्यापित नहीं | सत्यापित नहीं |
| टाइमिंग-लॉक्ड प्लेसमेंट | हाँ | आंशिक | सत्यापित नहीं | सत्यापित नहीं | आंशिक | सत्यापित नहीं | सत्यापित नहीं |
| सहमति-आधारित वॉइस क्लोनिंग | हाँ | आंशिक | आंशिक | आंशिक | आंशिक | आंशिक | आंशिक |
| लिप-सिंक | रोडमैप | सत्यापित नहीं | आंशिक | हाँ | आंशिक | सत्यापित नहीं | सत्यापित नहीं |
| ऑन-प्रिमाइसेस | हाँ | नहीं | नहीं | नहीं | सत्यापित नहीं | नहीं | नहीं |
प्रतिस्पर्धियों की जानकारी 6 नवंबर 2026 को वेंडर्स के अपने पेजों पर जाँची गई। लिंक हमारे रिसर्च नोट्स में हैं। "सत्यापित नहीं" का मतलब है कि हम इसकी पुष्टि नहीं कर सके।
लाइसेंसिंग और प्राइसिंग मॉडल
कीमतें वॉल्यूम और डिप्लॉयमेंट पर निर्भर करती हैं। हम दो कार्यदिवसों में कोटेशन देते हैं।
प्रति मिनट, प्रति लेयर
ट्रांसक्राइब · सबटाइटल · अनुवाद · डबसिर्फ़ उन्हीं स्टेप्स के लिए भुगतान करें जिनकी आपको ज़रूरत है।
मिनट बंडल
मासिकस्थिर वॉल्यूम वाली टीमों के लिए।
प्रति-टाइटल पैकेज
एपिसोड या फ़ीचर फ़िल्मब्रॉडकास्ट डिलीवरी के लिए तय कीमत, रिव्यू सहित।
प्राइवेट डिप्लॉयमेंट
सालाना, प्रति GPU नोडउन ब्रॉडकास्टर्स और संस्थानों के लिए जो ऑडियो पब्लिक क्लाउड पर नहीं भेज सकते।
खरीदार जो सवाल पूछते हैं
ट्रांसक्रिप्शन कितना सटीक है?
हमारे CPU बेसलाइन मॉडल के साथ 50 Common Voice क्लिप पर अंग्रेज़ी में 12.9% वर्ड एरर रेट; प्रोडक्शन इंजन इससे बेहतर करते हैं। हर भाषा का नतीजा उसके टेस्ट के साथ, पूरा होते ही प्रकाशित करते हैं।
क्या डब सिंक से बाहर होगा?
हर लाइन अपने मूल शुरुआती समय पर रखी जाती है और कभी खींची नहीं जाती। अगर कोई लाइन 1.35× पर भी फ़िट न हो, तो जॉब रिपोर्ट उसका नाम बताती है ताकि एडिटर उसे छोटा कर सके।
यह कितने स्पीकर संभाल सकता है?
यह स्पीकर्स की संख्या पहचानता है और हर एक को एक आवाज़ देता है। स्पीकर्स की संख्या पहले से बताने पर, 72 असली रिकॉर्डिंग पर लेबलिंग 91% सटीक रही।
क्या आप हमारे प्रेज़ेंटर की आवाज़ क्लोन कर सकते हैं?
सिर्फ़ प्रेज़ेंटर की रिकॉर्ड की गई सहमति से। क्लोन उसी जॉब के लिए इस्तेमाल होता है और बाद में डिलीट कर दिया जाता है।
आप कौन-से सबटाइटल फ़ॉर्मैट एक्सपोर्ट करते हैं?
SRT, WebVTT, TTML, SCC और JSON, या तस्वीर में बर्न-इन सबटाइटल।
क्या लिप-सिंक है?
अभी नहीं। यह रोडमैप पर है, और जब तक इसे मापा नहीं जाता, हम इसका दावा नहीं करेंगे।
क्या हम इसे प्राइवेट तौर पर चला सकते हैं?
हाँ, अपने GPU सर्वर के लिए प्राइवेट डिप्लॉयमेंट लाइसेंस के साथ।